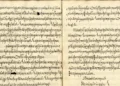
Inteligência artificial decodificou em 29 minutos um trecho do Cifra Borg, manuscrito preservado há séculos na Biblioteca Apostólica Vaticana.
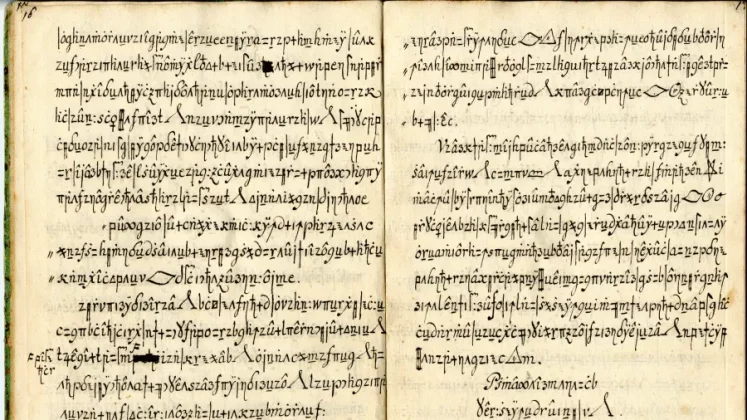
O documento tem 408 páginas, foi produzido provavelmente no século 17 e reúne receitas medicinais incomuns e descrições de artefatos incendiários.
O experimento usou um manuscrito cujo código já era conhecido pelos pesquisadores.
Um manuscrito de 400 anos guardado no Vaticano acaba de revelar seus segredos com ajuda da IA
O teste, divulgado pela revista The Business Standard em maio de 2026, analisou uma amostra de 500 símbolos.
A decifração não foi a primeira leitura do documento: a Universidade de Estocolmo já havia decifrado o código em 2016, em um projeto documentado em dissertação de maio de 2017.
A ferramenta digital processou em 29 minutos uma informação que especialistas humanos já conheciam.
O manuscrito, catalogado como Borg.lat.898 no acervo Vaticano, apresenta 34 caracteres distintos, formados por sinais gráficos e letras latinas com marcas adicionais.
Textos em latim e italiano descrevem práticas médicas que refletem crenças do período.
Uma das receitas recomendava coral vermelho, açafrão e vinho para o que chamavam de “tremor do coração”.
Outro trecho indicava pele de toupeira contra dores nas mamas, acompanhado de um ritual ligado à morte do animal.
O estudo acadêmico que acompanhou a decifração não comprovou a eficácia de nenhuma dessas prescrições.
Além de medicina, o Cifra Borg continha descrições de artefatos de guerra, especialmente preparações incendiárias.
Uma passagem descrevia fogo que supostamente duraria vinte anos e não seria apagado pela água.
O trabalho acadêmico não demonstrou que tal preparação funcionasse conforme descrito ou tivesse sido usada em combate.
A primeira página também trazia símbolos que pareciam árabes, mas eram latim escrito com caracteres desse idioma.
O pesquisador Ambjörn Sjörs, da Universidade de Uppsala, identificou essa transcrição e contribuiu para esclarecer o padrão do manuscrito.
Como pesquisadores quebraram o código?
A decifração original partiu de Nada Aldarrab, Kevin Knight e Beáta Megyesi, vinculados à Universidade do Sul da Califórnia e à Universidade de Uppsala.
A equipe transcreveu manualmente três páginas cifradas e depois testou o material com modelos de 16 línguas europeias.
Os algoritmos indicaram o latim como idioma mais provável, e um modelo estatístico baseado em sequências de cinco letras ajudou a reconstruir as correspondências entre sinais e letras.
O latinista Urban Örneholm confirmou a legibilidade, interpretou abreviações e refinou a tradução final.
As manchas e o desgaste do pergaminho tornaram decisiva a intervenção humana, porque nenhum sistema automático conseguiria resolver sozinho as ambiguidades do documento.